
接手项目,不等于
继承全部对话。
一个开发任务结束了。接下来,要验证已经做好的功能,或者修复另一个缺陷。你会继续在原来的会话里工作,先压缩上下文,fork 一份历史,还是重新开一个 session?
我们最初想找的是“上下文重力”:旧任务留下的目标、假设和工作习惯,会不会把模型拉回原来的方向,让它做不好新任务?于是,我们在 Sunny 的隔离环境里,用真实开发过程积累历史,再交给模型新的 E2E 验证与 bugfix 任务。
我们做了两轮实验,使用两个模型,对比五种方式,每组重复三次。检查交付物和执行记录后,我们仍无法确定:上下文超过多长,才会影响下一项任务。
我们会先试新会话+短摘要。但这只是目前的选择,实验还没有证明它最好。
这里最容易误解的是“新开”。新开组仍然拿到相同的新任务说明、代码、文档和证据。它能读到项目文件,只是不继承旧聊天。E2E 和 bugfix 都需要交接,我们比较的是要不要额外带上聊天历史,以及带多少。
同一份工作,五种接手方式。
项目状态和目标任务保持一致,改变的是新任务开始时携带的对话。
新会话,加一份短摘要。
在新开基础上提供共用冻结交接摘要,由 Sol 生成。摘要不是为每次目标任务重新定制的。
第一轮使用此前积累的长开发历史。第二轮把旧工作换成更复杂的开发过程:持久队列、幂等、租约与 fencing、取消、崩溃恢复和重试预算。完成阶段验收后,我们冻结项目和历史,再分出五种策略。这里的“复杂任务”是旧上下文的来源,不是第三类目标任务。
E2E 任务要求验证已有的导出功能。遇到预期内的失败,也要如实报告。Bugfix 则要求修复可见文本的脱敏:对象的结构标识和原始差异比较不能变,显示内容和布局宽度都要使用脱敏后的文本。只改显示、不改布局,也算失败。
自己比较,代价花在哪里。
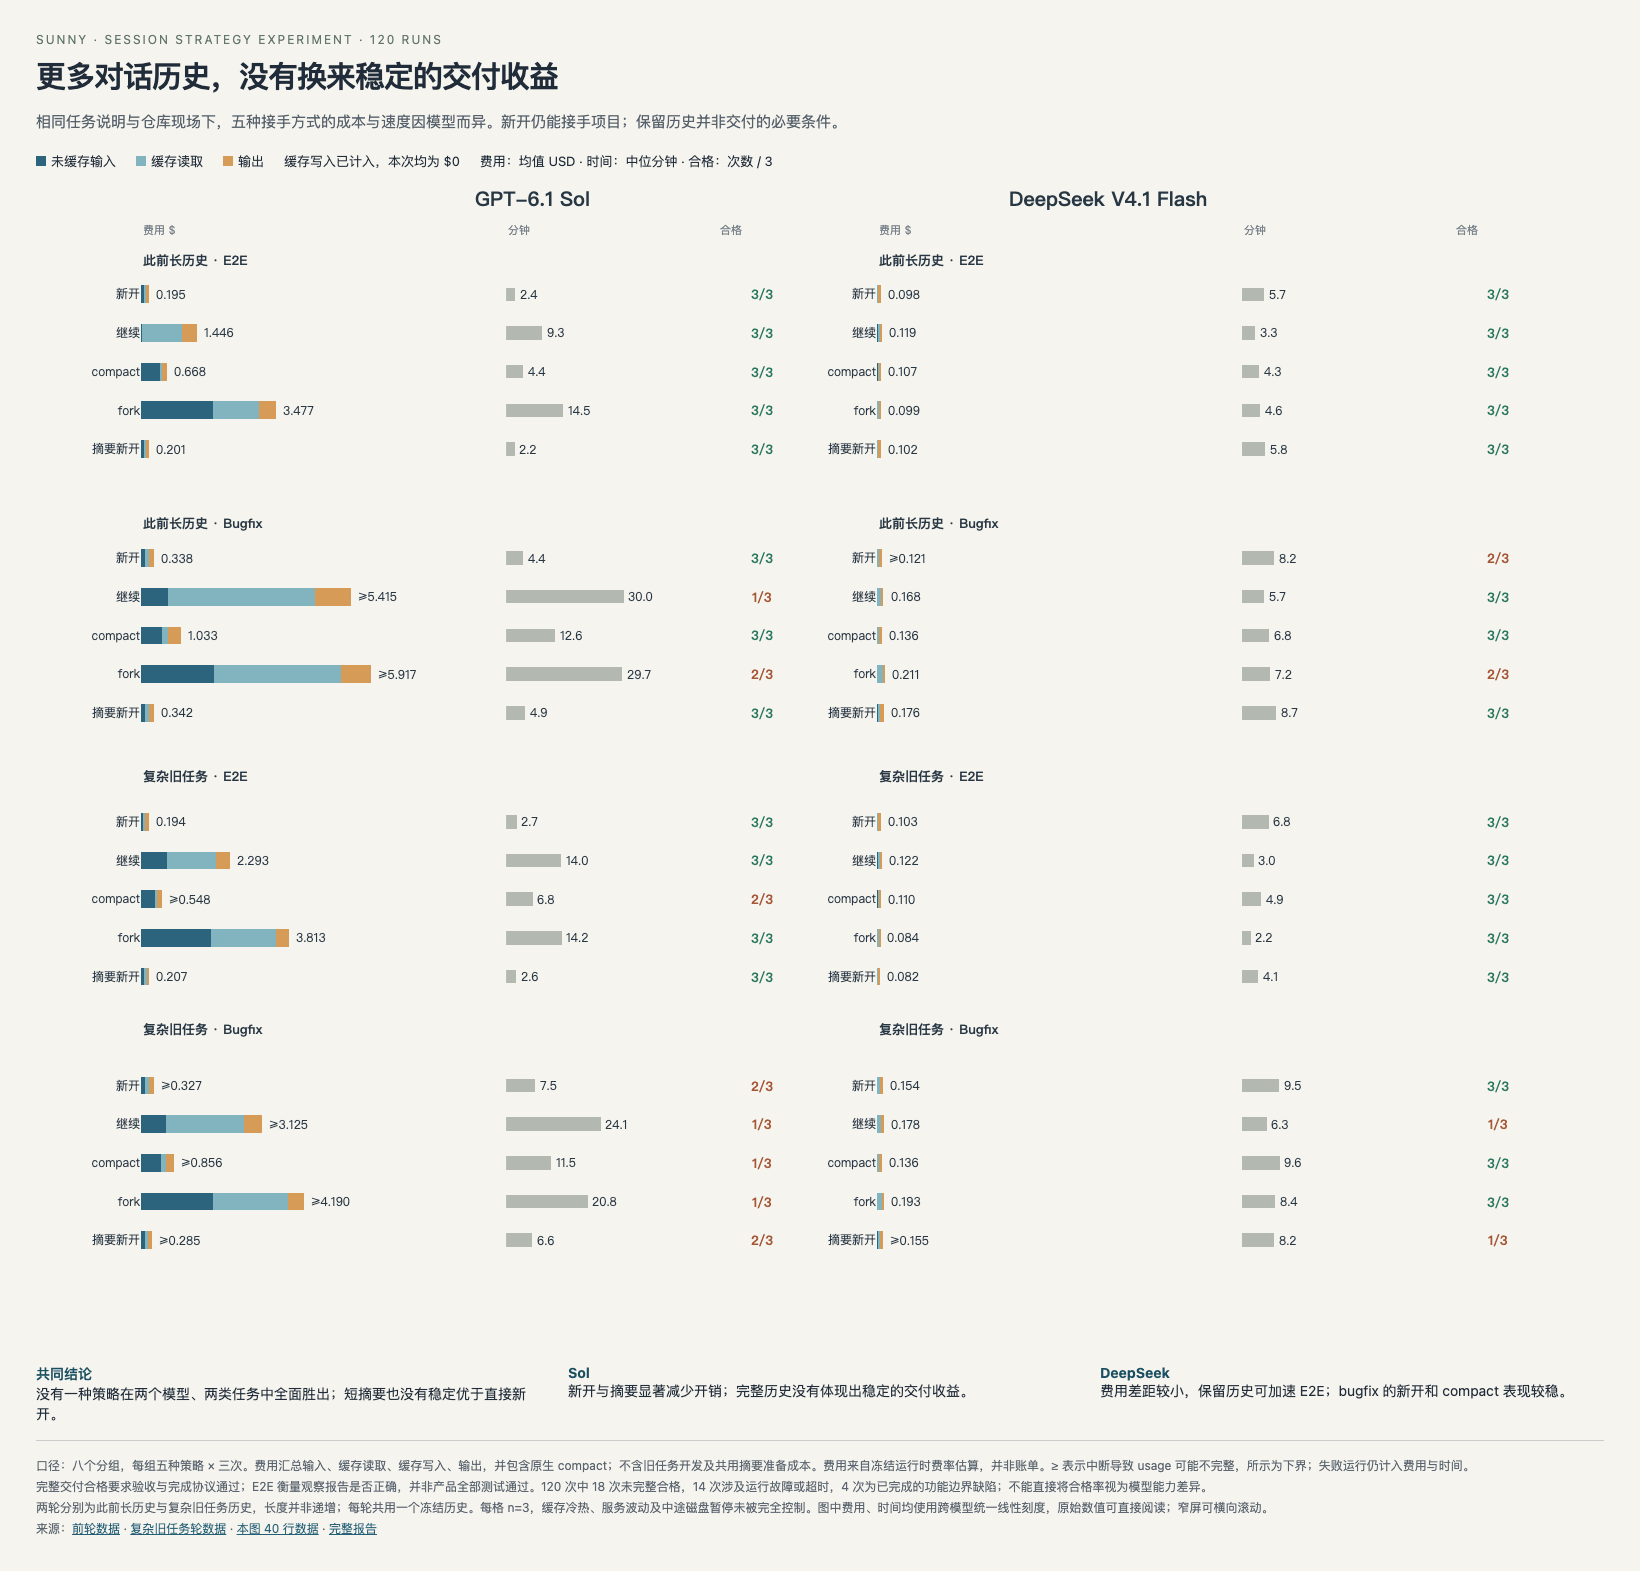
切换八组实验,观察同一任务里五种策略的费用、时间和交付。每种策略三次运行。
费用为三次均值(美元),时间为中位分钟。费用刻度 $0–6。可跨组比较。
点选任一策略,查看四类费用。≥ 是中断造成的记录下界;失败尝试仍计入均值。费用与时间均包含原生 compact,不含旧任务开发及共用摘要准备成本。缓存写入已计入,本次记录均为零。
八组一起看:摘要新开相对直接新开

相同的策略,
在两个模型上并不等价。
Sol 的结果最一致。两轮 E2E 中,新开、继续、fork、摘要新开都完成了 6/6 次完整交付。新开每次平均约 $0.19,耗时中位数约 2.4–2.7 分钟;继续是 $1.45–2.29、9.3–14.0 分钟;fork 是 $3.48–3.81、14.2–14.5 分钟。完整历史没有在这项验收里带来额外收益。
但 DeepSeek 给出了不同的速度排序。复杂旧任务轮的 E2E 中,新开约 6.8 分钟,继续约 3.0 分钟,fork 约 2.2 分钟,且均为 3/3 合格。上一轮则是继续最快。对它来说,携带历史有时能省时间,费用差距也小得多。
在 bugfix 上,DeepSeek 的新开与 compact,两轮功能验收各为 6/6;compact 的平均费用两轮都约 $0.136。但时间从 6.8 分钟变为 9.6 分钟。费用接近,不等于执行过程相同。
这些分组结果提示:新开、摘要交接和压缩都值得考虑,但各自的优势并不一致。Sol 的新开开销较低;DeepSeek 的速度排序随任务变化。短摘要也没有稳定胜过直接从任务说明和仓库接手。
缓存命中,也有成本。
继续会话的缓存读取费用
约为新开任务全部费用的 6.5 倍。
继续会话的三次 E2E,平均每次累计读取约 633 万个缓存 token。历史在多次调用中反复进入输入;“命中缓存”只说明单次读取更便宜,并不等于整个任务便宜。
此外,Sol 的完整历史组平均输出 token 约为新开组的 2.8–3.8 倍。Trace 里可以看到更长的验证过程、脚本与重复检查。这些运行做了更多工作,但我们不能说增加的每一步都是多余的。
长输入的费率更高,也推高了费用。我们保持记录用量不变,只去掉长输入加价,重新算了一次。本轮 Sol E2E 的继续与 fork,分别有约 47% 和 49% 的记录费用来自这项加价。价格阶梯造成的成本增加,不是上下文重力的证据。
为什么 fork 可能更贵?
原生 fork 复制历史,同时产生新的 session ID。12 对 same / fork 的消息内容一致,但缓存表现不一定相同。Sol 一组首请求中,继续有 425,984 个缓存读取 token,fork 则把 426,666 个 token 记为未缓存输入;首请求费用约从 $0.090 变为 $1.710。
运行时会将 session ID 用于缓存键,这提供了机制线索;但我们没有服务端因果实验。继续会话也曾发生冷缓存,DeepSeek 的 fork 也能命中缓存。因此不能概括为“fork 一定丢缓存”。
没有交付完成,
不一定是没有做对。
120 次运行中,102 次完整合格。其余 18 次里,14 次涉及运行故障或超时,4 次是已完成的功能边界缺陷。某些中断发生时,代码已经通过验收,只是最终交付协议还没完成。
真正的缺陷值得单独看。它们集中在 DeepSeek 的脱敏任务:有的把可见路径误当成不可修改的结构身份,遗漏脱敏;有的显示文本已经替换,布局宽度却仍使用原始文本。后者违反了明确的布局边界,但不能直接说成“敏感文本泄露”。
同类路径遗漏在前一轮 fork 中也出现过,因此不能把它归因于第二轮复杂旧任务。旧任务词汇确实偶尔出现在报告的范围说明里,但 60 次复杂轮运行没有修改旧任务模块。我们看到了旧任务用语残留,以及更多的检查和输出,还没有看到稳定的“旧任务接管新任务”。
下一步,优先试新会话+短摘要。
我们会先试新会话+短摘要。但这只是目前的选择,实验还没有证明它最好。
我们希望用短摘要带走关键决策和未完成事项,不必把整段聊天都搬过去。本次实验还没有充分验证这个想法:各组使用同一份事先生成的摘要,没有为每项新任务重写,也没有把摘要生成成本算进去。
各组结果并不一致。Sol 的摘要与新开组表现接近。DeepSeek 的复杂轮 E2E 中,摘要约 $0.082、4.1 分钟,新开约 $0.103、6.8 分钟;但上一轮两者接近,两轮 bugfix 的摘要功能验收为 4/6,新开为 6/6。
我们尚未找到稳定最优策略,也未识别出上下文重力阈值。每组只跑了三次,部分运行还遇到了故障。下一步,我们会为新任务单独整理摘要,把生成摘要的成本也算进去。还要测试一种情况:关键决策只在旧聊天里,仓库里找不到。
方法、来源与限制
这 120 次实验是怎么来的?
两轮 × 两模型 × 两目标任务 × 五策略 × 三次重复。模型为 gpt-6.1-sol(medium)和 deepseek-flash(请求 medium,运行时解析为 high)。每轮使用一份固定的开发历史,各组都从这份历史开始。三次重复并不代表三份独立的开发历史。
真实开发积累上下文,不使用合成档案,也不使用 CURRENT.md 提醒任务切换。复杂旧任务阶段完成 161 项自身测试及 9 项独立验收;schema migration 与 dashboard 未纳入该阶段最终范围。
每个目标在隔离项目现场运行;保留原始 trace、验收和交付。四个 E2E 原始判分因“允许的独立验证脚本位置”被人工复核修正,原判分保留;前轮也修复过评估器缺失依赖造成的误判。没有因此让模型重跑。
费用如何计算?
费用 = 未缓存输入 + 缓存读取 + 缓存写入 + 输出,按消息记录计算,原生 compact 计入。推理若已归入输出,不另加一次。采用实验冻结运行时的美元费率,不是公开现价或实际账单。
每百万 token:Sol 基础费率依次为 $2 / $0.10 / $2.50 / $10;输入总量(含缓存)超过 272,000 时为 $4 / $0.20 / $5 / $15。DeepSeek 依次为 $0.30 / $0.006 / $0 / $1.20。
共用短摘要由 Sol 生成后冻结;摘要组没有获得为每次任务重新定制的摘要。
图表衡量接手后的运行费用,包含原生 compact,不包含旧工作开发和共用摘要的准备成本。复杂轮共用摘要生成一次,记录约 $0.09585、23 秒。未完整记录 usage 的中断运行以 ≥ 标为下界。中断导致的低费用不代表成功交付更划算。
为什么还不能给出上下文重力阈值?
两轮同时改变了旧任务内容,长度也不是单调递增。Sol 和 DeepSeek 在运行时配置的窗口分别是 50 万和 100 万 token。我们没有验证服务端实际允许的最大长度。缓存冷热、服务路由、主机负载没有完全控制;复杂轮曾因磁盘容量暂停后恢复,已完成运行未重试。每组只跑三次,小差异可能只是波动。
新开仍可读仓库,因此本实验对“只有旧会话才知道关键信息”的交接覆盖不足。超时和传输故障属于用户真实体验,但不能全算成推理或任务切换能力失败。
页面排版与探索交互参考 Anthropic 的 What will our economic future look like?。实验、结论与图表数据来自 Sunny;参考网站不是实验结论的来源。